先换源
同一个关键词换一个源再搜。能搜到就是原先那个源的问题,与客户端无关。
venera 的漫画源决定了它能搜到什么:源以脚本或配置文件的形式接进来,负责把某个漫画站的数据翻译成客户端能读的结构。接好之后,首页搜索、题材分类和章节列表才会一起可用;搜不到东西时,按源的顺序排查比乱改设置快得多。
首页 / 漫画源
仓库地址、单个源文件、自己写的脚本,三种都能用,差别在维护成本。
最省事的是填仓库地址:在漫画源页面的仓库输入框里粘贴一个公开的源配置地址,刷新之后列表会列出里面所有的源,每个源后面带版本号,更新时点一次检查更新。这种方式一次能接入十几到二十个源,适合刚上手的人。
第二种是单个源文件:手里只有一个 .json 或 .js 文件时,用导入功能把它读进来,好处是来源清楚,坏处是源更新了要自己重新导入一遍。
第三种是自己写。venera 的源本质是一段脚本,负责实现搜索、详情、章节、图片四个动作,懂 JavaScript 的话改一份现成的比从零写快得多。
按接入方式、更新方式与出错时的表现做对照。
表格按接入方式分成三行,出错表现一列最值得先看。
| 接入方式 | 一次能接多少 | 怎么更新 | 出错时的表现 |
|---|---|---|---|
| 仓库地址 | 十几到二十个 | 点检查更新,整批同步 | 列表能刷出来但个别源检索为空 |
| 单个配置文件 | 一个 | 重新导入覆盖 | 导入时就报格式错误 |
| 自写脚本 | 一个 | 自己改代码 | 检索有结果但章节或图片为空 |
三种方式可以混用,不必二选一。
每一步都能排除一类原因,不要跳着试。
同一个关键词换一个源再搜。能搜到就是原先那个源的问题,与客户端无关。
书名带符号或繁体写法时容易搜不到,换成作者名或去掉符号再试一次。
两个源都空、关键词也简单,才去看网络:源地址是否可达,是否被运营商拦。
能搜到作品但点进去没有章节,说明源的详情接口变了,等源更新。
章节列表正常、图片全空,通常是图床被拦,换源最快,改设置没用。
把失效的源停用而不是删掉,下次它更新了你还能一键恢复。
一处是发现页的缩略图与分类入口,一处是阅读时的翻页设置。
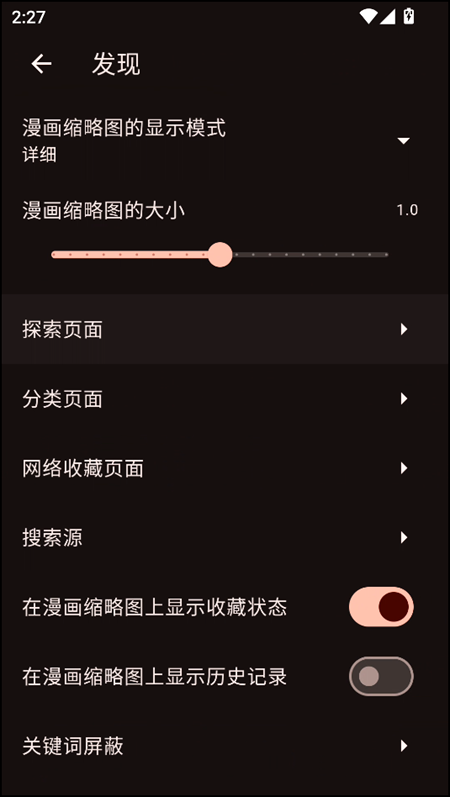
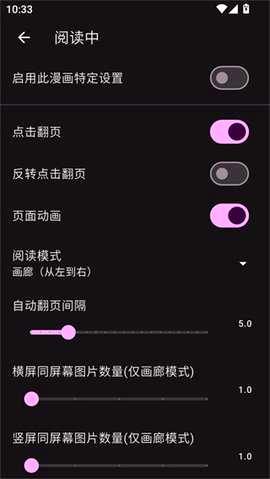
都是接完源之后马上会遇到的问题。
接上、试搜、加书架,这三步走完再谈调优。